

Tech & IP
컴퓨팅 및 스토리지 자원 최적화를 위한 LLM 분석 및 재구성 기술
보유기관 : 한국전자통신연구원
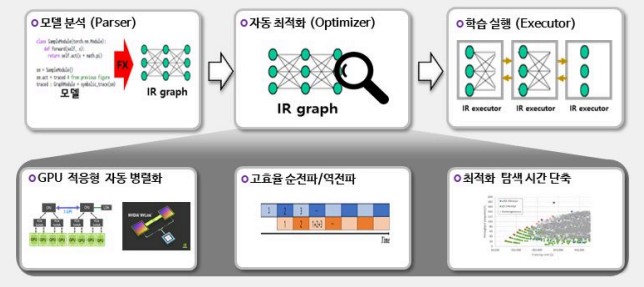
기술개요
이 기술은 LLM 전문가와 인프라 전문가의 수동 분석 없이 소프트웨어로 모델을 자동 분석한다. 분석 결과를 바탕으로 보유 컴퓨팅 인프라에 맞게 워크로드를 배치· 병렬화·최적화해 컴
특허정보
| 특허명 | 특허출원번호 | 출원일자 | |||
|---|---|---|---|---|---|
| 특허명 | 채널 공유 네트워크 환경에서의 딥러닝 분산 학습 방법 | 특허출원번호 | 12314201 | 출원일자 | 2023-06-30 |
- 기술개요
-
이 기술은 LLM 전문가와 인프라 전문가의 수동 분석 없이 소프트웨어로 모델을 자동 분석한다. 분석 결과를 바탕으로 보유 컴퓨팅 인프라에 맞게 워크로드를 배치· 병렬화·최적화해 컴퓨팅 효율을 향상한다
- 기술 도입 필요성
-
• AI가 효율화 시대에 진입했으나, 기존 기술은 특정 모델과 하이퍼 인프라(DGX)에 의존해 오픈소스 기반 다양한 모델과 엔트리·미드급 이종 인프라에는 적용이 어려웠다
• 이에 모델과 인프라 종속성 없이 GPU·NVMe 등 고가 가속기·스토리지를 자원 효율적으로 배치·활용해 이종 컴퓨팅 자원 효율을 높이는 기술이 필요하다
- 기술 특장점
-
• Bert, GPT2, GPT-Neo, GPT-J, OPT, Llama2/3, Electra, Whisper, VIT 등 주요 공개 LLM의 워크로드 특성을 자동으로 분석해 모델 중립성을 확보했다
• A100과 NVLink 기반 하이퍼 인프라뿐 아니라 A40과 PCIe 등 엔트리·미드급 인프라까지 지원해 인프라 중립성도 갖췄다
• 3D 병렬화, 체크포인팅, 혼합정밀도, 호스트 오프로딩, 스토리지 티어링 등의 기법으로 워크로드 배치·병렬화· 최적화를 지원한다
• 이를 통해 모델과 인프라에 대한 종속성 없이 이종 컴퓨팅 자원의 효율을 향상시킨다