

Tech & IP
VLM기반의 실환경 한글 수어 인식 AI 기술
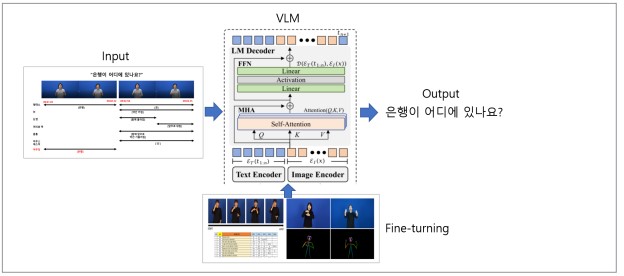
기술개요
알파벳을 사용하는 해외 수어에 비해 자모음이 조합된 방식의 한글 수어 인식은 기술적 난이도가 높고 인식 정확도가 낮아 활용이 어려운 단점이 존재했다. 본 기술은 VLM을 기반으로
특허정보
| 특허명 | 특허출원번호 | 출원일자 | |||
|---|---|---|---|---|---|
| 특허명 | VLM기반의 실환경 한글 수어 인식 AI 기술 | 특허출원번호 | - | 출원일자 | - |
- 기술개요
-
알파벳을 사용하는 해외 수어에 비해 자모음이 조합된 방식의 한글 수어 인식은 기술적 난이도가 높고 인식 정확도가 낮아 활용이 어려운 단점이 존재했다. 본 기술은 VLM을 기반으로 AI허브에 존재하는 수어 데이터를 학습시켜, 실시간으로 높은 인식 정확도로 추론하는 AI 기술을 개발함
- 기술개발 목적 및 필요성
-
• AI-허브 사이트에는 한글 기반의 수어문장 2,000개, 수어단어 3,000개, 지숫자/지문자 1,000개의 AI 학습용 데이터 가 존재하나, 수어 인식율은 WER기준 26.7%로 약 73%의 인식 성공률로 실환경 사용이 어려움
• 기존의 Deep learning 방식(CNN, LSTM, ViT 등)을 이용한 다양한 한글 수어 인식기 개발이 시도되고 있으나, 상용 화 수준에는 이르지 못함
• 최근 인공지능의 발달로 LLM의 성능이 급격히 향상됨에 따라 VLM의 성능 또한 향상되고 있어, VLM을 기반으로한 한글 수어 인식 기술 개발이 필요
- 기술의 특징 및 장점
-
• 한글 수어 인식을 위한 대용량 학습 데이터 전처리 기술
- 수어 문장, 수어 단어, 지숫자/지수어 영상 크기 정규화 기술
- 수어 문장, 수어 단어, 지숫자/지수어 영상 프레임 샘플링 기술
- 수어 문장, 수어 단어, 지숫자/지수어 학습데이터 태깅 기술
• VLM 기반의 실시간 수어 인식 기술
- VLM 모델 성능 분석 및 모델 크기 분석 기술
- VLM 모델 fine-turning 및 최적화 기술
- VLM과 LLM을 연동한 문장 생성 기술