

Tech & IP
최신성을 지속 가능하게 유지할 수 있는 생성형 언어모델 기술
기술개요
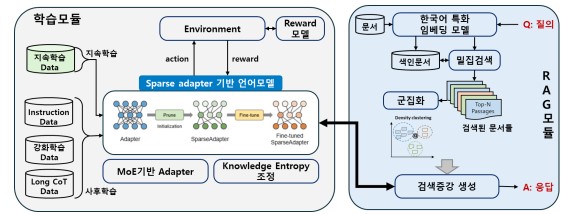
사전학습(pre-training) 이후의 최신지식을 생성형 언어모델의 내재정보(parametric knowledge)로 최신화하는 지속학습(continual learning) 및
특허정보
| 특허명 | 특허출원번호 | 출원일자 | |||
|---|---|---|---|---|---|
| 특허명 | 심층 언어모델의 점진적 지식 학습 방법, 추론 장치 및 추론 방법 외 1건 | 특허출원번호 | 10-2025-0106494 외 1건 | 출원일자 | - |
- 기술개요
-
사전학습(pre-training) 이후의 최신지식을 생성형 언어모델의 내재정보(parametric knowledge)로 최신화하는 지속학습(continual learning) 및 사후학습(post-training)을 위한 기술과 검색증강생성(RAG)에서 질의에 부합하는 최신 외부정보(non-parametric knowledge) 재순위화를 위한 한국어 특화 텍스트 임베딩(text embedding) 및 군집화(clustering) 기술
- 기술개발 목적 및 필요성
-
• 저비용으로 생성형 언어모델의 최신성을 지속 가능하게 유지할 수 있는 학습 및 이를 최신성이 필요한 태스크에 활용 하는 기술의 개발/보급이 필요
• 생성형 언어모델은 다양한 분야에서 범용인공지능에 가까운 성능을 보임에도 불구하고, 계속 사용이 될 때 최신 정보 반영이 어려울 뿐 아니라 지속적으로 반영하는 것 또한 고비용이 수반되는 어려운 문제임. 따라서, 최신성을 지속 가 능하게 유지할 수 있는 최신성 학습 기술과 검생증강 생성을 위한 기반 기술이 필요
• 검색증강 생성기술은 뛰어난 검색 및 재순위화 기술에 기반하여 소형 언어모델(sLM)에서도 좋은 성능을 보이므로, 검색 및 재순위화를 위해 한국어에 특화된 밀집검색(dense retrieval) 및 군집화(clustering)기술이 필요
- 기술의 특징 및 장점
-
• 효율적인 학습을 위한 sparse adapter 기반 지속학습 기술
- MoE(Mixture of Experts) 기반 고용량(high-capacity) adapter 지속학습 기술
- 부분 미세조정(partial finetuning)을 이용한 메모리와 속도에 효율적인 지속학습 기술
- 지식 엔트로피(knowledge entropy)를 이용한 망각완화 및 적응적 지속학습 기술
• 사후학습을 위한 미세조정 기술
- Sparse adapter를 활용한 효과적인 미세조정 기술
- 도메인 특화 instruction tuning을 위한 미세조정 기술
- Long CoT(chain-of-thought) 적용을 위한 효율적인 미세조정 기술
- 사용자의 선호도 기반 응답 생성에 효과적인 강화학습 기술
• 한국어 특화 텍스트 임베딩 및 군집화 기술
- 한국어 특화 언어이해모델(ETRI Roberta-large) 기반 한국어 텍스트 임베딩 기술
- 최적 손실함수(sigmoid weighted InfoNCE)를 적용한 효과적인 한국어 텍스트 임베딩 기술
- 한국어 특화 텍스트 임베딩 모델을 이용한 의미단위 군집화 기술