

Tech & IP
온디바이스-엣지 간 AI 분할 추론 기술
기술개요
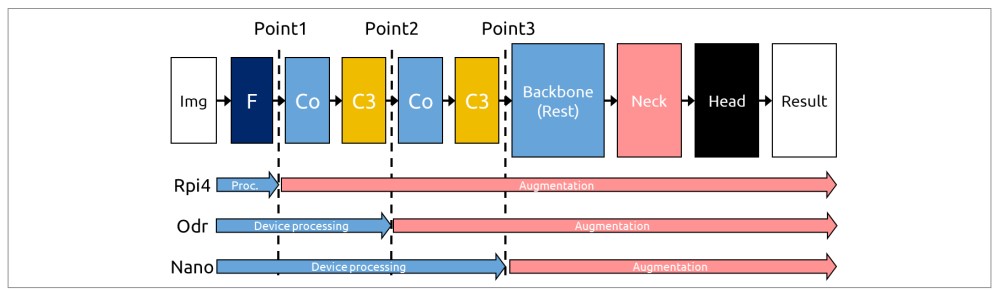
단일 온디바이스에서 실행하기 어려운 고성능 AI 모델을 다수의 연산 가능한 부분(Sub-model)으로 자동 분할하고, 이를 현장의 여러 엣지 디바이스에 분산 배치하여 협력적으로
특허정보
| 특허명 | 특허출원번호 | 출원일자 | |||
|---|---|---|---|---|---|
| 특허명 | 엣지 컴퓨팅 환경에서 분산 협업 기반 프로토콜 변환 방법 및 시스템 | 특허출원번호 | 10-2024-0143722 외 1건 | 출원일자 | 2024-10-21 외 1건 |
- 기술개요
-
단일 온디바이스에서 실행하기 어려운 고성능 AI 모델을 다수의 연산 가능한 부분(Sub-model)으로 자동 분할하고, 이를 현장의 여러 엣지 디바이스에 분산 배치하여 협력적으로 추론(Co-inference)을 수행하는 기술임. 이 기술은 개별 디바이스의 하드웨어 성능 한계를 극복하고, 데이터 발생 지점에서 즉각적인 AI 분석 및 실시간 서비스 제공을 가능하게 함
- 기술개발 목적 및 필요성
-
• 제조산업의 디지털 전환이 가속화됨에 따라, 생산 설비에서 발생하는 데이터가 기하급수적으로 증가하여 현장에서 의 즉각적인 대응과 예측을 위해 데이터 분석 수요가 확대되고 있으며, 기존의 중앙 집중식 클라우드 방식은 데이터 전송 지연, 네트워크 부하, 통신 비용 등의 한계를 가짐
• 따라서, 방대한 데이터를 유/무선 네트워크를 통해 공장 내에서 신속하게 처리하고 고성능으로 분석할 수 있는 On- Site 엣지 컴퓨팅 기술이 필수적임
• 특히, 여러 장비와 공정을 동시에 관리하기 위해서는 다수의 엣지 서버를 효율적으로 통합 운영하는 클러스터 시스템 이 요구됨
- 기술의 특징 및 장점
-
• 온디바이스-엣지 간 AI 추론의 분할 및 분산 실행
- 모델 분할(Model Partitioning): 대규모 AI 모델의 연산 그래프를 분석하여 다수의 독립적인 서브 모델로 자동 분할
- 최적 분산 배치(Optimal Distribution): 각 엣지 디바이스의 연산 능력, 메모리, 네트워크 상태를 고려하여 분할된 서브 모델을 최적으로 배치하는 스케줄링 기술
- 협력적 추론(Collaborative Inference): 분산된 서브 모델들이 중간 결과값을 효율적으로 교환하며 전체 AI 추론 을 협력적으로 완료함으로써, 단일 고성능 서버와 유사한 수준의 결과를 도출
• 온디바이스와 협력적으로 추론하는 이동형 엣지 컴퓨팅 시스템
- 데이터가 발생한 현장에서 즉시 처리하여 중앙 서버와의 통신 병목 현상을 제거하고, 빠른 응답 속도를 보장
- 현장에서 처리된 핵심 결과 데이터만 중앙 서버로 전송하여 전체 데이터 트래픽을 감소시키고, 클라우드 사용 및 네 트워크 인프라 비용 절감
- 민감한 생산 및 공정 데이터를 외부로 전송하지 않고 내부망에서 처리하므로, 데이터 유출 위협을 원천적으로 차단하 고 보안을 강화합니다